


Finance werkt met een van de meest gedisciplineerde datasets van elke organisatie: dubbel boekhouden, een methode van meer dan vijf eeuwen oud, dwingt af dat elke boeking sluit. De rapportage- en planninglaag daarbovenop draait nog vaak op spreadsheets. In de FP&A Trends Survey 2024 was Excel bij 52% van de organisaties de belangrijkste planningsapplicatie.
Die kloof is het onderwerp van deze gids. Financiële business intelligence betekent hier de data, modellen en rapportages die grootboek- en planningsdata omzetten in de cijfers waarop finance en directie vertrouwen: de maandafsluiting, managementrapportages, budgetten en forecasts. (Voor analytics in bank en verzekeringen, zie financiële dienstverlening.) De gids toetst ook welke veelgebruikte cijfers standhouden wanneer u ze naar de bron terugvolgt.
Eén bevinding bepaalt de rest: de grondigst gemeten foutenfrequentie die wij vonden en die relevant is voor financiële rapportage zit niet in het enterprise resource planning-systeem (ERP) of in het dashboard. Ze zit in de spreadsheets ertussen.
Kort gezegd: bouw de productielaag voor rapportage als laatste. Breng de spreadsheets achter elk gerapporteerd cijfer in kaart, verplaats de berekeningen met de grootste gevolgen naar een getest model, meet waar de dagen van de afsluiting werkelijk blijven en automatiseer pas daarna de rapportage. Waar u begint, hangt af van het symptoom: een late afsluiting begint met meten, gecorrigeerde cijfers beginnen bij de werkmappen.
Op deze pagina
- Hoe lang hoort een afsluiting te duren?
- Waar gaat de tijd van finance werkelijk naartoe?
- Wat is het foutpercentage in de spreadsheetlaag?
- Hoe vaak blijken gerapporteerde cijfers fout?
- Kan analytics de forecastnauwkeurigheid verbeteren?
- Waar beginnen bij het bouwen van financiële rapportage
- Veelgestelde vragen
Belangrijkste inzichten
- In september 2026 toonde de open, branchebrede benchmark van het American Productivity & Quality Center (APQC) (meting 104615) een mediane maandelijkse financiële afsluiting van 8,0 dagen bij 3.389 organisaties. De open pagina toont geen kwartielen, geen meetperiode en niet of het om kalender- of werkdagen gaat.
- In Raymond Panko’s overzicht van veldaudits had 24% van 367 operationele spreadsheets minstens één gevonden fout; de latere audits, met betere methoden, vonden fouten in 91% van 54. In laboratoriumexperimenten waarin mensen alleen spreadsheets bouwden, bedroeg het gemiddelde foutpercentage per cel 3,2% over 547 spreadsheets in negen onderzoeken.
- Bij bedrijven die rapporteren aan de Amerikaanse Securities and Exchange Commission (SEC) kwamen materiële restatements (“Big R”) in 2005–2024 gemiddeld ongeveer 3% per jaar voor, volgens het Public Company Accounting Oversight Board (PCAOB).
- Het cijfer “75% van de tijd gaat naar het verzamelen van data” is echt onderzoek onder teams voor financial planning and analysis (FP&A), maar het veldwerk is van 2018–19 en het wordt vaak zonder die datering herhaald.
- Per 3 oktober 2026 vonden wij geen geloofwaardige benchmark over bedrijven heen voor de afwijking van interne forecasts. Een peer-reviewed overzicht van 130 onderzoeken naar prognoses van het management over de winst beschrijft wat de nauwkeurigheid bepaalt, niet één foutpercentage.
- In een praktijkonderzoek uit 2024 beoordeelden organisaties die hun datakwaliteit als hoog omschreven hun eigen forecasts ruim drie keer zo vaak als goed of uitstekend als organisaties met lage datakwaliteit (71% tegenover 21%). Het verschil tussen gebruikers en niet-gebruikers van AI of machine learning was kleiner: 65% tegenover 40%.
Hoe lang hoort een afsluiting te duren?
De benchmark die hier wordt gebruikt is meting 104615 van APQC’s Open Standards Benchmarking, de doorlooptijd in dagen van de maandelijkse financiële afsluiting. De meting valt binnen het proces “Perform general accounting” en negen deelprocessen, van het bijhouden van het rekeningschema en het verwerken van journaalposten tot intercompany-afstemming, consolidatie en eliminaties, de proefbalans en managementcorrecties.
Over 3.389 organisaties, branchebreed, ligt de mediaan op 8,0 dagen (zoals getoond in september 2026; de live steekproef kan veranderen).
Dat is een redelijk referentiepunt, met kanttekeningen. De open pagina toont alleen de mediaan: de kwartielkolommen zijn leeg voor bezoekers die niet zijn ingelogd en er wordt geen meetperiode genoemd. APQC publiceert ook een tweede meting rond de afsluiting, en die twee zijn makkelijk te verwarren:
| APQC-meting | Wat wordt gemeten | Eenheid | Mediaan | Steekproef |
|---|---|---|---|---|
| 104615, maandelijkse financiële afsluiting | De afsluiting binnen “Perform general accounting” (de negen deelprocessen hierboven) | “Dagen”; kalender- of werkdagen niet vermeld | 8,0 | 3.389 |
| 100162, maandelijkse geconsolideerde jaarrekening | Vanaf het draaien van de eerste maandelijkse proefbalans tot het gereedkomen van de geconsolideerde cijfers | Kalenderdagen, weekenden meegeteld | 6,0 | 11.223 |
De twee klokken starten en stoppen op verschillende momenten, dus de 6,0 is geen snellere versie van de 8,0. Per 3 oktober 2026 konden wij de bewering “topprestaties sluiten in vier dagen af”, die in marketing rond finance-transformatie opduikt, niet verifiëren; wij herhalen haar daarom niet. Noemt een leverancier een benchmark voor de afsluiting, vraag dan uit welke APQC-meting die komt en wanneer de data is verzameld.
Een afsluitingscyclus zegt bovendien pas iets naast wat er wordt afgesloten: een bedrijf met één entiteit, één valuta en één ERP voert niet hetzelfde proces uit als een groep die twaalf dochterondernemingen in vier valuta’s consolideert, met intercompany-eliminaties. De branchebrede mediaan voegt organisaties van sterk verschillende complexiteit samen en de open pagina toont niet hoe de steekproef zich daarover verdeelt. Bepaal voordat u acht dagen als doel neemt waar uw eigen complexiteit u waarschijnlijk in die verdeling plaatst.
De bruikbaardere vraag is niet hoe u zich verhoudt, maar waaruit die acht dagen bestaan. Een afsluiting kan traag zijn zonder dat de boekhouding moeilijk is, door afhankelijkheden: wachten op de aanlevering van een dochteronderneming, wachten op een schatting van een accrual vanuit operations, wachten op een afstemming die één persoon handmatig uitvoert, en een deel daarvan opnieuw doen wanneer een late correctie binnenkomt. Of dat voor uw afsluiting geldt, is te meten: leg gedurende twee cycli taaktijd, wachttijd, herwerk en late correcties vast.
Het automatiseren van de rapportage verkort de laatste stap: het opleveren van het pakket zodra de cijfers definitief zijn. Op zichzelf doet het weinig aan de keten van afhankelijkheden die bepaalt wanneer de cijfers definitief worden. Tools die ook afstemmingen of taakstromen van de afsluiting automatiseren, reiken verder die keten in, dus beoordeel elke tool aan de hand van de gemeten oorzaken van vertraging. Een versnellingsprogramma dat bij het automatiseren van het rapportagepakket begint, werkt riskant aan het verkeerde eind: het pakket is eerder klaar, maar de cijfers zijn niet eerder definitief.
Waar gaat de tijd van finance werkelijk naartoe?
U komt de bewering tegen dat “finance 75% van de tijd besteedt aan het verzamelen van data en 25% aan analyse”. Ze komt uit echt onderzoek en verdient zowel een datering als een nauwere omschrijving.
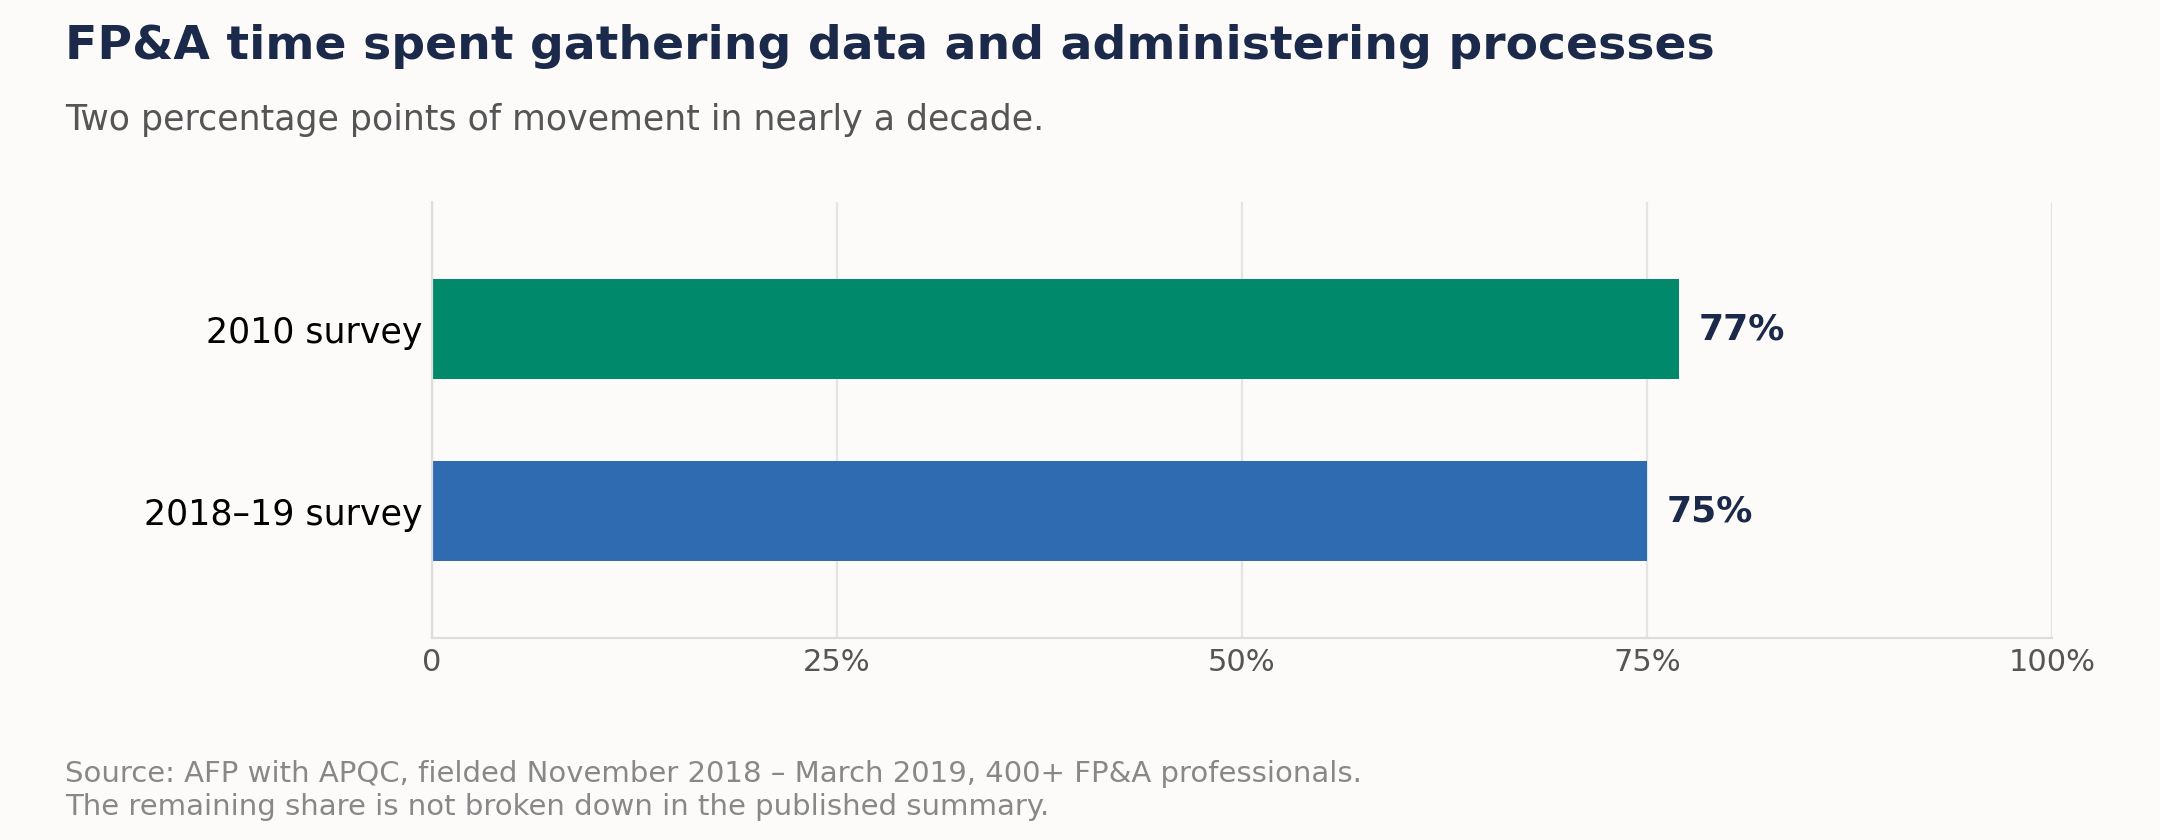
De bron is een gezamenlijk onderzoek van AFP en APQC onder meer dan 400 FP&A-professionals, bevraagd en geïnterviewd tussen november 2018 en maart 2019. Respondenten meldden dat hun FP&A-teams 75% van hun tijd besteden aan het verzamelen van data en het beheren van processen, slechts twee procentpunt minder dan de 77% in 2010. De gepubliceerde samenvatting specificeert het resterende kwart niet, dus “25% aan analyse” is een afleiding, geen bevinding. Slechts 22% van de respondenten omschreef hun analytics als voorspellend of prescriptief.
Het is legitiem onderzoek, maar het gaat over FP&A-teams en niet over finance als geheel, en het weerspiegelt veldwerk uit 2018–19.
Een recenter praktijkonderzoek, de FP&A Trends Survey 2024 (383 respondenten, gepubliceerd in juni 2024), meldt een andere verdeling: 45% van de FP&A-tijd gaat naar dataverzameling en validatie tegenover 35% naar inzichten verwerven en acties aansturen, een verdeling die volgens het rapport de afgelopen vier jaar stabiel is. Een andere vraag, een ander instrument en een kleinere, door een leverancier gesponsorde enquête, dus de twee zijn niet rechtstreeks vergelijkbaar. Wat ze delen is smaller: het verzamelen en voorbereiden van data kost nog altijd een groot deel van de FP&A-tijd.
| Onderzoek | Veldwerk en steekproef | Tijd aan dataverzameling | Tijd aan inzicht en analyse |
|---|---|---|---|
| AFP en APQC | Meer dan 400 FP&A-professionals, bevraagd en geïnterviewd van november 2018 tot maart 2019 | 75% verzamelen van data en beheren van processen (77% in 2010) | Niet uitgesplitst in de gepubliceerde samenvatting; “25% aan analyse” is een afleiding |
| FP&A Trends Survey 2024 | 383 respondenten, gepubliceerd in juni 2024 | 45% dataverzameling en validatie | 35% inzichten verwerven en acties aansturen |
Per 3 oktober 2026 vonden wij geen actuele, grootschalige meting door een beroepsorganisatie van deze verdeling waarvan het percentage in een toegankelijke samenvatting wordt gepubliceerd. Het brede patroon is dus goed onderbouwd, maar de huidige omvang ervan is niet precies bekend.
Wat is het foutpercentage in de spreadsheetlaag?
Fouten in spreadsheets worden al tientallen jaren onderzocht. Raymond Panko’s samengevatte onderzoek omvat veldaudits van operationele spreadsheets en gecontroleerde ontwikkelexperimenten. De steekproeven uit de veldaudits zijn oud en klein, en de spreadsheets zijn niet allemaal financieel, hoewel veel van de gecontroleerde spreadsheets financiële modellen waren. De twee lijnen vertellen een consistent verhaal:
| Maatstaf | Resultaat | Basis |
|---|---|---|
| Veldaudits waarin minstens één fout werd gevonden, alle audits | 24% | 367 spreadsheets, veldaudits samengevat in Panko’s paper uit 2000 |
| Veldaudits vanaf 1997, met betere methoden | 91% | 54 spreadsheets (zelfde paper) |
| Veldaudits sinds 1995, bijgewerkte samenvatting | 88% | 113 spreadsheets in zeven onderzoeken (herziening van 2008) |
| Foutpercentage per cel in afzonderlijke veldaudits | ongeveer 0,4%–2,5% | 1,1%–2,5% in drie grote spreadsheets uit twee audits; 0,4% in een audit waarin alleen formules met een hoger risico werden gecontroleerd |
| Gemiddeld foutpercentage per cel, ontwikkelexperimenten | 3,2% | 547 spreadsheets, door individuen alleen gebouwd, negen onderzoeken (Panko’s samenvatting) |

De rijen over de veldaudits zijn geen onafhankelijke metingen: de 54 spreadsheets maken deel uit van de 367, en het totaal van 113 uit 2008 omvat dezelfde 54. Panko schrijft het verschil tussen 24% en 91% toe aan betere auditmethodiek in de latere onderzoeken, niet aan slechtere spreadsheets. Dat werkt twee kanten op. Zorgvuldige inspectie vindt meer van wat er is, dus de 24% onderschat het probleem waarschijnlijk. Maar de 91% en de 88% komen van 54 en 113 spreadsheets die tussen 1995 en 2007 zijn gecontroleerd, dus geen van beide is een schatting voor de spreadsheets die nu in gebruik zijn, en “ongeveer 90% van de spreadsheets bevat fouten” zonder die context overdrijft de bewijsbasis. De meeste audits in de samenvatting van 2000 telden bovendien alleen inhoudelijke fouten, niet elke fout.
Een foutpercentage van enkele procenten per cel stapelt zich op. Alleen ter illustratie: als elke cel een onafhankelijke kans van 3,2% had om fout te zijn, bevatte een keten van dertig formulecellen in ongeveer 62% van de gevallen minstens één foute cel (1 − 0,968³⁰). Dat is niet de kans dat het gerapporteerde cijfer fout is: echte fouten zijn niet onafhankelijk en sommige veranderen de uitkomst niet. Panko waarschuwt dat het percentage een langetermijngemiddelde is en niet klopt voor een specifieke spreadsheet, en veel experimenten gebruikten studenten, dus zie dit als indicatie van de orde van grootte. Het praktische punt blijft staan: veel spreadsheetfouten blijven onopgemerkt. Een verkeerd bereik in een SOM-formule levert een aannemelijk getal op, geen foutmelding.
Deze onderzoeken maten hoe vaak spreadsheets fouten bevatten; ze maten niet in hoeverre het verplaatsen van een berekening naar een gemodelleerde, onder versiebeheer staande laag die fouten vermindert. Wat zo’n laag wel kan, is controles afdwingbaar maken: wijzigingen in het model worden vastgelegd en tests kunnen bij elke release draaien, mits de uitrol beheerst verloopt en handmatige aanpassingen zijn vergrendeld of gelogd. Het verlaagt het risico alleen als het nieuwe model is afgestemd op het grootboek, is getest tegen bekende uitkomsten en is beoordeeld door iemand anders dan de bouwer. Zo gedaan richt het zich op een probleem waarvan de omvang daadwerkelijk is gemeten.
Het helpt ook te verklaren waarom fouten een review overleven. Neem structurele fouten: een bereik dat één rij te kort bleef toen iemand een regel invoegde, een hardgecodeerd getal waar een verwijzing hoort, een formule over een rij gekopieerd die niet relatief had moeten zijn. Bij doorlezen zien ze er niet fout uit. In Panko’s overzicht van methoden om fouten te verminderen was inspectie van code cel voor cel de enige techniek die toen werkte, en die is traag.
De praktische toets voor welke berekeningen u eerst verplaatst, is niet complexiteit. Het is gevolg en stilte: hoever het getal reist en of iemand verderop zou merken dat het tien procent fout was. Een cijfer dat in een bestuurspakket staat en met niets anders sluit, is de eerste kandidaat.
Hoe vaak blijken gerapporteerde cijfers fout?
De analyse van het PCAOB uit oktober 2025 van data van Audit Analytics (in het algemeen zonder 1940 Act-filers, pensioenplannen en de restatements voor SPAC-warrants uit 2021) laat zien dat materiële restatements (“Big R”) in 2005 tot en met 2024 ongeveer 3% per jaar voorkwamen. Een Big R-restatement wordt gemeld op Form 8-K, Item 4.02: eerdere jaarrekeningen mogen niet langer worden vertrouwd. Daarnaast had gemiddeld 29% van de bedrijven met Big R-restatements het voorgaande jaar van auditor gewisseld, tegenover een gemiddeld wisselpercentage van 11% in de bredere populatie.
Het rapport van Ideagen Audit Analytics van mei 2026, dat SEC-registranten beslaat en naast Big R-restatements ook de minder ernstige “little r”-herzieningen meetelt, komt voor 2025 uit op 391 restatements, 18% minder dan de 477 in 2024. Alleen 2020 lag lager in de twintig jaar aan data. De samenvatting van het rapport door Accounting Today noemt 375 voor 2020 en komt voor 2025 op een aandeel van 5,1% van de bedrijven met een restatement, zonder te zeggen op welke populatie dat aandeel is gebaseerd. De piek in 2021 was geen algemene verslechtering: na een standpunt van SEC-medewerkers over de verwerking van warrants werden dat jaar meer dan 1.000 restatements van special-purpose acquisition companies (SPAC’s) ingediend, tegenover 13 in 2025.
| Bron | Reikwijdte | Bevinding |
|---|---|---|
| PCAOB, oktober 2025 | Materiële restatements (“Big R”), 2005 tot en met 2024 | Een frequentie van ongeveer 3% per jaar; gemiddeld had 29% van de bedrijven met Big R-restatements het voorgaande jaar van auditor gewisseld, tegenover 11% in de bredere populatie |
| Ideagen Audit Analytics, mei 2026 | SEC-registranten; Big R- en “little r”-restatements | 391 restatements in 2025, 18% minder dan de 477 in 2024; alleen 2020 lag lager in 20 jaar aan data |
| Samenvatting van Accounting Today | Hetzelfde rapport | 375 restatements in 2020; 5,1% van de bedrijven met een restatement in 2025, zonder te zeggen op welke populatie dat is gebaseerd |
Voor een private middelgrote onderneming (hier grofweg 50 tot 249 medewerkers, de middelgrote categorie van de EU), of elk bedrijf dat niet bij de SEC rapporteert, zijn deze cijfers context en geen benchmark, en ze zeggen niets rechtstreeks over foutpercentages bij private bedrijven. Ze laten wel zien dat bij extern gecontroleerde bedrijven die bij de SEC rapporteren nog steeds met een frequentie van ongeveer 3% per jaar materiële fouten aan het licht komen. Dat is geen bewijs dat minder streng gecontroleerde rapportage slechter scoort, maar wel een reden om niet aan te nemen dat ze beter scoort.
Kan analytics de forecastnauwkeurigheid verbeteren?
Mogelijk, maar het gepubliceerde bewijs dat wij vonden meet het effect niet, en de onderstaande enquêtedata laten verbanden zien, geen oorzaken.
Per 3 oktober 2026 zochten wij naar een geloofwaardige benchmark over bedrijven heen voor de afwijking van bedrijfsforecasts en vonden er geen. Het meest relevante wetenschappelijke werk dat wij vonden gaat over een ander soort prognose: een peer-reviewed overzicht uit 2022 van 130 onderzoeken naar prognoses van het management over de winst (de verwachtingen die beursgenoteerde bedrijven publiceren) vat samen wat de nauwkeurigheid bepaalt, zoals omvang van het bedrijf, eerdere nauwkeurigheid, governance en dekking door analisten, en rapporteert geen geconsolideerd foutpercentage. De zoekopdracht liet andere bedrijfsforecasts buiten beschouwing, zoals die voor kasstroom en omzet. Per 3 oktober 2026 vonden wij geen sectorbrede MAPE voor interne forecasts.
Wat er wel is, is zelfgerapporteerd en moet ook zo worden benoemd. In de FP&A Trends Survey 2024 onder 383 praktijkmensen beoordeelde 42% de eigen forecasts als goed of uitstekend. Bij organisaties die AI of machine learning voor forecasting gebruiken was dat 65%, tegenover 40% bij organisaties die dat niet doen. Het scherpere contrast is datakwaliteit: 71% bij organisaties met hoge datakwaliteit, tegenover 21% bij organisaties met lage datakwaliteit. Datakwaliteit is hier de eigen omschrijving van de respondenten van hun data (één bron met afgesproken definities bovenaan, meerdere bronnen waarvan de definities tijd kosten om te analyseren onderaan), geen externe maatstaf. En de groep met AI en machine learning is klein: slechts 6% van de respondenten gebruikte AI of ML bij forecasting, en het rapport geeft voor die subgroep geen aantal of foutmarge.
| Groep (FP&A Trends Survey 2024) | Beoordeelde eigen forecasts als goed of uitstekend |
|---|---|
| Alle 383 respondenten | 42% |
| Gebruikt AI of machine learning bij forecasting | 65% |
| Gebruikt geen AI of machine learning | 40% |
| Hoge datakwaliteit | 71% |
| Lage datakwaliteit | 21% |
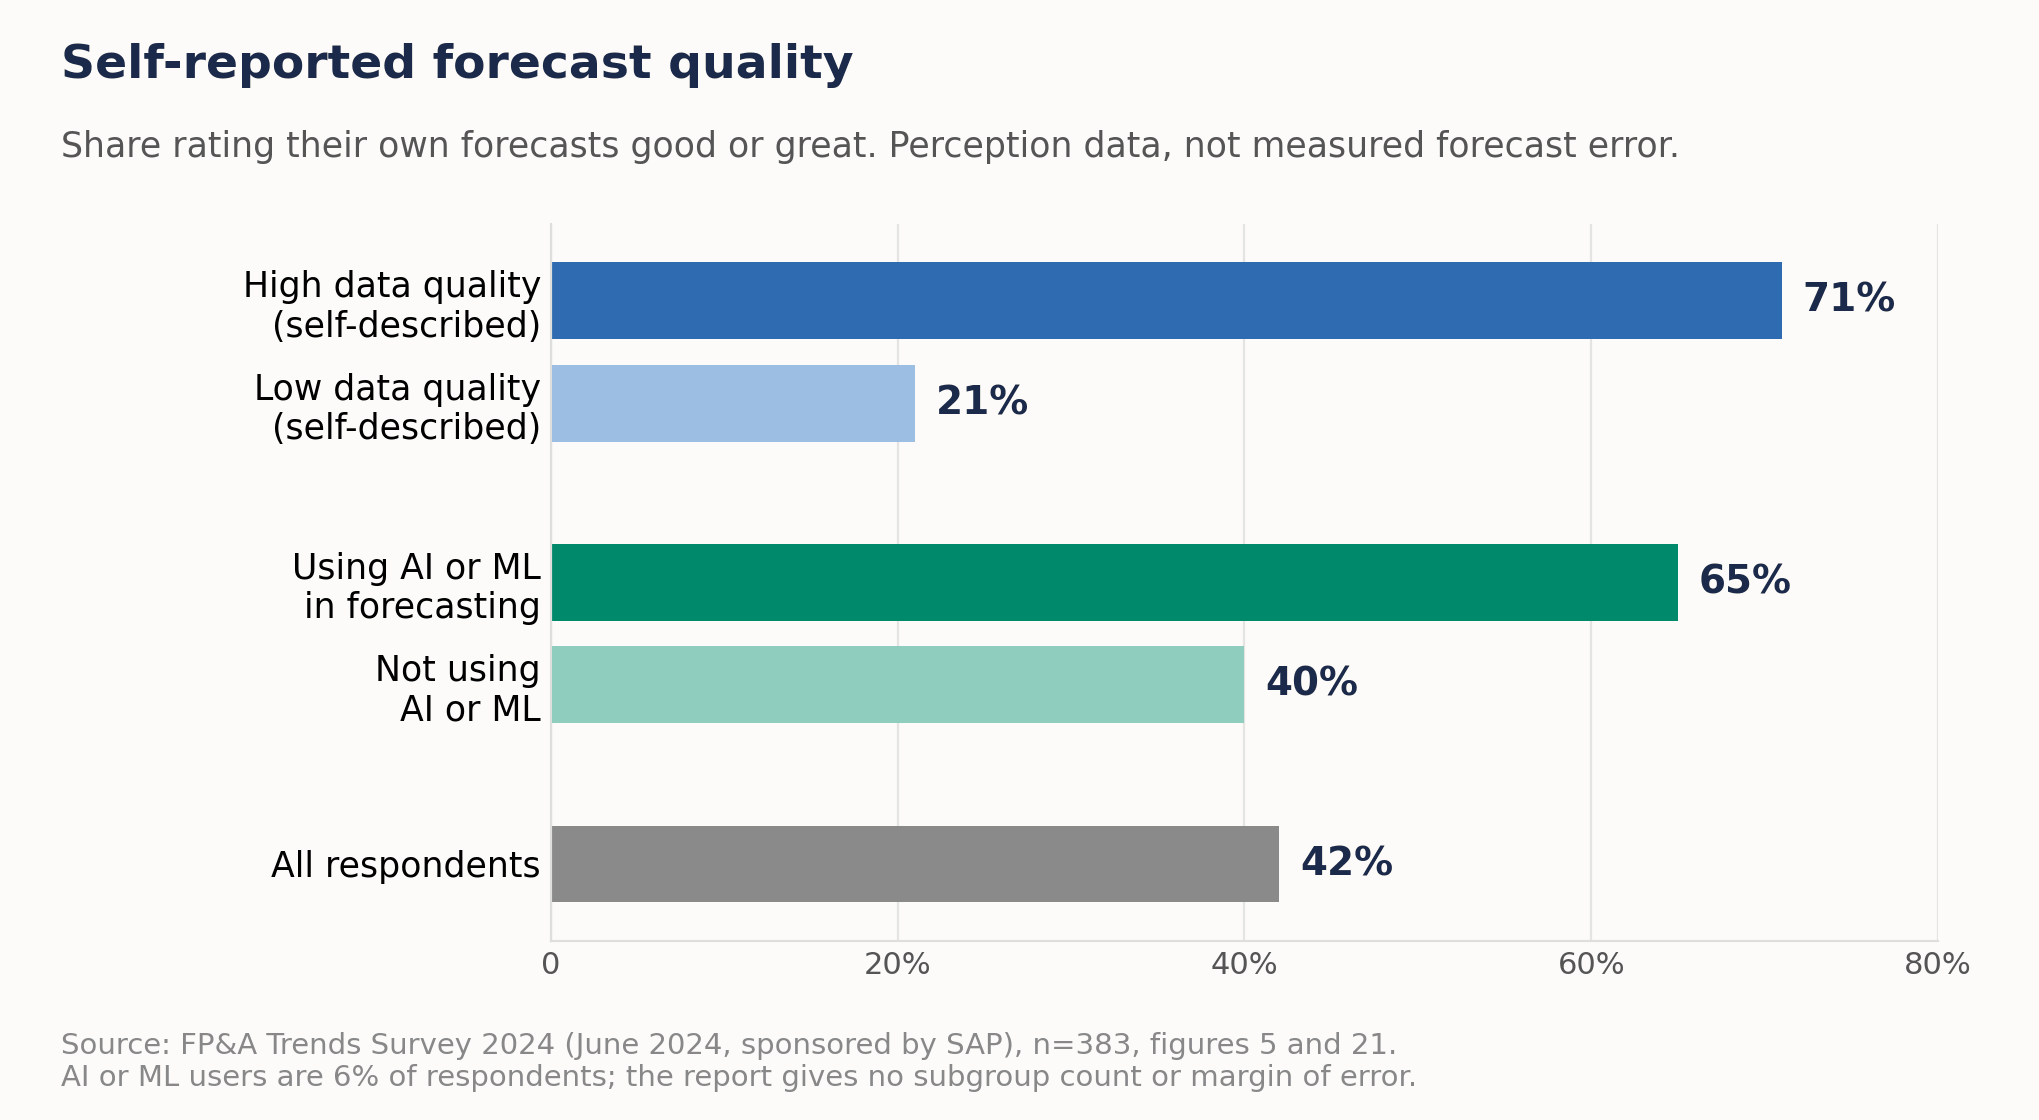
Het contrast bij datakwaliteit is meer dan drie op één; het contrast bij AI en machine learning is ongeveer 1,6 op één. Ze zijn niet helemaal vergelijkbaar, omdat het ene de top en de onderkant van drie datakwaliteitsgroepen vergelijkt en het andere gebruikers met niet-gebruikers, en de gepubliceerde cijfers de twee effecten niet scheiden. Het verband ondersteunt het controleren van de invoerlaag voordat u een nieuwe methode aanschaft, maar een eenmalige zelfbeoordeling kan geen oorzaak en gevolg aantonen. Een basiscontrole omvat de weinige drijvers die de forecast domineren: zijn de invoergegevens compleet, in elke bron op dezelfde manier gedefinieerd, op tijd beschikbaar en afgestemd op het grootboek of het bronsysteem?
Wie in forecasting heeft geïnvesteerd, beoordeelt de eigen forecasts mogelijk hoger, en dat is niet hetzelfde als dat die forecasts nauwkeuriger zijn. Per 3 oktober 2026 vonden wij hier geen gemeten benchmark, dus wanneer een leverancier een sectorbreed foutcijfer voor forecasts noemt, vraag dan om het onderzoek.
Waar beginnen bij het bouwen van financiële rapportage
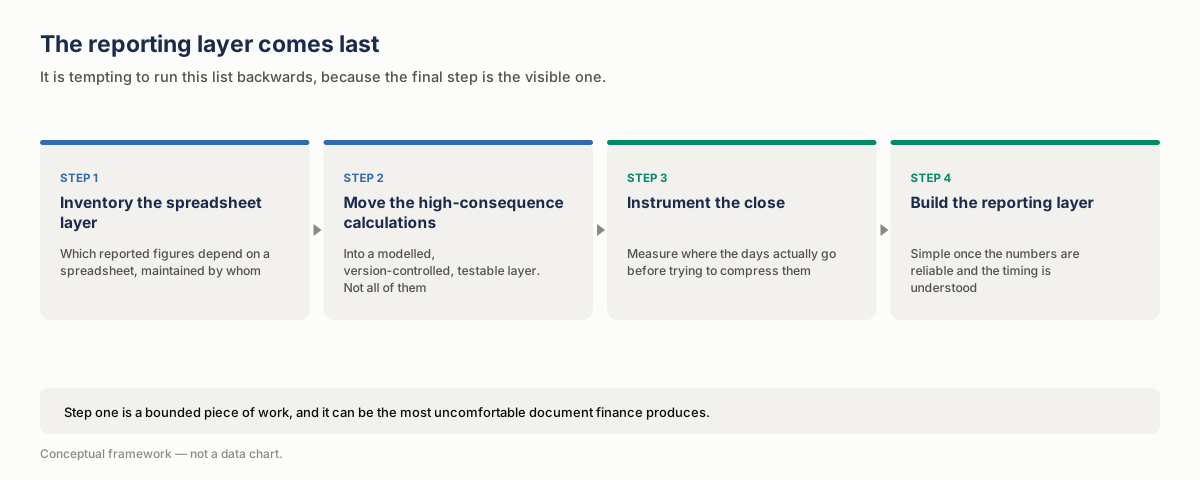
Samen genomen wijst het bewijs hierboven op een volgorde waarin de productielaag voor rapportage als laatste komt. Een dun prototype van het pakket kan naast de eerste stappen blijven draaien om definities te testen en te zien wat de gebruikers nodig hebben; wat wacht, is de productiebouw.
| Stap | Actie | Wat het inhoudt | Waarom in deze volgorde |
|---|---|---|---|
| 1 | De spreadsheetlaag inventariseren | Voor elk gerapporteerd cijfer: welke werkmap het produceert, wie die onderhoudt, hoe vaak ze draait, welke rapportages ze voedt, waarop ze wordt afgestemd, hoeveel handmatige stappen erbij komen kijken en wat er gebeurt als die persoon niet beschikbaar is. Rangschik de lijst met de toets van gevolg en stilte hierboven. | De omvang hangt af van het aantal entiteiten, bronsystemen en terugkerende werkmappen, dus bepaal de reikwijdte voordat u de inspanning schat. Het kan het meest ongemakkelijke document zijn dat de financiële afdeling ooit opstelt. |
| 2 | De berekeningen met de grootste gevolgen naar een getest model verplaatsen | Niet alle, en niet in één keer. Begin met de berekeningen waarbij een onopgemerkte fout in een bestuurspakket terecht zou komen. Keur elke berekening pas goed wanneer finance de definitie heeft goedgekeurd, de uitkomst binnen een afgesproken tolerantie sluit met het grootboek (of, voor planningscijfers, met een afgesproken bron), bekende uitkomsten inclusief randgevallen worden gereproduceerd, de toegang tot de juiste rollen is beperkt en de vorige versie kan worden hersteld. | Een onopgemerkte fout in een bestuurspakket is de duurste fout, dus die berekeningen komen eerst |
| 3 | De afsluiting meetbaar maken | Meet waar de dagen werkelijk blijven: welke afhankelijkheid te laat komt, welke afstemming handmatig is, welke correctie herwerk veroorzaakt. | Een cyclus die u niet hebt gemeten, is lastig te verkorten, en de meting is ook de nulmeting waarmee u stap vier beoordeelt |
| 4 | De productielaag voor rapportage als laatste bouwen | Zodra de cijfers betrouwbaar zijn en de timing begrepen is, is het automatiseren van het pakket vergelijkenderwijs eenvoudig. | Het is het onderdeel dat goed te demonstreren is maar het minst verandert |
De juiste eerste stap hangt af van het symptoom:
| Als het belangrijkste probleem is… | Begin met |
|---|---|
| De afsluiting is te laat klaar | Stap 3: meten waar de dagen blijven |
| Gerapporteerde cijfers worden aangevochten of gecorrigeerd nadat het pakket is verstuurd | Stap 1 en 2: die cijfers naar hun werkmappen terugvolgen en op het grootboek afstemmen |
| De cijfers worden vertrouwd, maar het pakket wordt met de hand samengesteld | Stap 4 kan de juiste eerste stap zijn |
| Forecasts zijn zwak | De invoercontrole uit het gedeelte over forecasting, voordat u de methode verandert |
Het is verleidelijk de lijst achterstevoren af te werken, omdat stap vier de zichtbare is. Voor een kijk van buitenaf voordat u zich aan een bouwtraject committeert, is een beoordeling van de huidige situatie van de spreadsheets en de planning van de afsluiting achter uw bestuurspakket het kleinste gepubliceerde beginpunt: het Discovery-pakket van Veralytiq, een nulmeting en gapanalyse van twee tot vier weken die uitmondt in een roadmap met geprioriteerde stappen. Zijn definities, bronkoppelingen of datakwaliteit instabiel, behandel dat dan als een datafundament-probleem dat u vóór of naast de rapportagebouw oplost.
Veelgestelde vragen
Verschilt financiële BI van de rest van business intelligence?
Vooral in waar het risico zit. Het begint bij gestructureerde boekhoudgegevens, met sluitende boekingen en afstemming ingebouwd in de routine. De zwakkere schakel is vaak de laatste stap: veel van de cijfers die bij de directie terechtkomen, kunnen door een spreadsheetlaag met een gemeten foutpercentage gaan.
Moeten we spreadsheets helemaal vervangen?
Meestal niet. Spreadsheets zijn uitstekend voor verkenning, eenmalige analyses en het modelleren van een scenario dat niemand had voorzien. De reden om iets eruit te halen is specifiek: het is een terugkerende berekening, een gerapporteerd cijfer hangt ervan af en een fout erin zou onopgemerkt blijven. Dat is een veel kleinere groep dan “alle spreadsheets”.
Wat mag een rapportageproject voor finance kosten?
De reikwijdte bepaalt dat meer dan het aantal rapporten: het aantal bronsystemen, entiteiten en valuta’s, hoe consistent het rekeningschema is, hoeveel historie u nodig hebt, eisen aan afstemming en beveiliging, de verversingsfrequentie en hoeveel procesverandering ermee gepaard gaat. Een geloofwaardige schatting noemt die aannames voordat ze een bandbreedte geeft, en daarom is een beoordeling vóór de prijsstelling van de implementatie verstandig. Om offertes te vergelijken, vraagt u elke leverancier om die aannames te noemen en discovery, bronintegratie, dataherstel, modellering en controles, rapportbouw, testen, training, licenties en doorlopende ondersteuning apart te prijzen. Aan de batenkant zijn de gegevens die u zelf kunt meten de uren die naar herwerk en het samenstellen van het pakket gaan en de dagen die de afsluiting op wachten verliest.
Kunnen we de afsluiting verkorten met betere rapportagetools?
Gedeeltelijk. Het automatiseren van het pakket verkort de laatste stap; tools die ook afstemmingen of workflows van de afsluiting automatiseren, reiken verder. Een groot deel van het wachten kan in de keten van afhankelijkheden zitten, en dat is een procesvraag. Meet taaktijd, wachttijd en herwerk over twee afsluitingen voordat u beslist aan welk eind u werkt.
En forecastingsoftware?
Het bewijs ondersteunt geen stellig antwoord. Per 3 oktober 2026 vonden wij geen gepubliceerde benchmark voor de afwijking van bedrijfsforecasts. In de zelfgerapporteerde enquêtedata verschillen de beoordelingen van forecasts sterk naar datakwaliteit (71% tegenover 21%) en minder sterk naar het gebruik van AI of machine learning (65% tegenover 40%), waardoor eerst de invoer op orde brengen en dan pas een methode kopen de voorzichtigere volgorde is.
Wie moet de definities in financiële rapportage beheren: finance of IT?
Een werkbare verdeling is dat finance de definitie beheert, IT of data de implementatie, en dat, waar het team groot genoeg is, geen van beide allebei doet. Waar één team beide moet doen, vullen onafhankelijke review en gedocumenteerde goedkeuring van wijzigingen het gat. Het risico wanneer IT de definities beheert, zijn technisch correcte cijfers die een iets andere vraag beantwoorden dan de gestelde. Het risico wanneer finance de implementatie beheert, is de spreadsheetlaag waar dit artikel over gaat.
De laag tussen het grootboek en het bestuurspakket
Ook waar de ERP goed beheerst is en de jaarrekening wordt gecontroleerd, kunnen de cijfers die de directie elke maand ziet door een keten van werkmappen gaan met lichter eigenaarschap, lichtere tests en lichtere wijzigingsbeheersing. Waar het foutpercentage van die laag is gemeten, loopt het van minder dan 1% tot enkele procenten van de cellen.
Uitzoeken of dat ook in uw organisatie zo is, vergt geen nieuwe tooling. Neem het meest recente bestuurspakket, volg elk cijfer naar de werkmap die het produceert en noteer wie die onderhoudt en waarop ze wordt afgestemd. Het is de goedkoopste van de vier stappen hierboven en het laat zien waar de andere drie moeten beginnen.
Gerelateerde artikelen
- BI per sector: complete gids voor Nederlandse middelgrote bedrijven — BI-toepassingen per sector
- Enterprise Business Intelligence: Gids voor Schaalbare Oplossingen — Business intelligence op enterprise-schaal
- KPI Dashboard Maken: Stap voor Stap van Data naar Inzicht — Stap voor stap van data naar een werkend KPI-dashboard
Bronnen
Peer-reviewed en fundamenteel
- Panko, Spreadsheet Errors: What We Know. What We Think We Can Do, EuSpRIG 2000. Veldaudits (tabel 1): 24% van 367 spreadsheets; 91% van 54 gecontroleerd vanaf 1997; inspectie van code cel voor cel als de enige bewezen techniek om fouten te verminderen.
- Panko, What We Know About Spreadsheet Errors, herzien in mei 2008 (gearchiveerde kopie). 88% van 113 spreadsheets gecontroleerd in zeven onderzoeken sinds 1995.
- Panko, Spreadsheet development experiments. Individuen die alleen werken: negen onderzoeken, 547 spreadsheets, totaal foutpercentage per cel 3,2%.
- Preussner & Aschauer, The Accuracy and Informativeness of Management Earnings Forecasts: A Review and Unifying Framework, Accounting Perspectives 21(2), 2022. Overzicht van 130 onderzoeken.
Toezichthouders
- PCAOB, Data Points: Financial Restatements and Auditor Turnover, oktober 2025. 2005–2024, op basis van data van Audit Analytics.
- Center for Audit Quality, Ten years of restatement trends, over 2013–2022.
Beroepsorganisaties en benchmarkconsortia
- APQC, Cycle time in days to complete monthly financial close, Open Standards Benchmarking, meting 104615, 3.389 organisaties, mediaan 8,0 dagen, zoals getoond in september 2026 (de browsertitel van de pagina verwijst naar shared service centers voor finance; de getoonde meting betreft de bedrijfsentiteit).
- APQC, Cycle time in days to complete the monthly consolidated financial statements, meting 100162, 11.223 organisaties, mediaan 6,0 kalenderdagen.
- Association for Financial Professionals met APQC, Five practices of highly effective FP&A teams, juli 2019. Veldwerk november 2018 – maart 2019, 400+ FP&A-professionals.
- FP&A Trends Group, FP&A Trends Survey 2024, juni 2024, gesponsord door SAP. 383 praktijkmensen; Excel de belangrijkste planningsapplicatie bij 52% van de organisaties (fig. 12); forecastbeoordelingen naar datakwaliteit (fig. 5) en met of zonder AI of ML, 65% tegenover 40% (fig. 21); 6% gebruikt AI of ML bij forecasting (fig. 13).
- ICAEW Library, The Earliest Books on Bookkeeping 1494 to 1683. Oorsprong van dubbel boekhouden, inclusief Pacioli’s tekst uit 1494.
Commerciële data
- Ideagen Audit Analytics, Financial Restatements, mei 2026. Dekking, volgens de databasebeschrijving van Ideagen: SEC-registranten, Big R- en “little r”-restatements. 391 restatements in 2025, 18% minder dan 477; 13 SPAC-gerelateerde restatements in 2025 tegenover meer dan 1.000 in 2021.
- Accounting Today, Financial restatements drop 18%, 5 juni 2026. Samenvatting van het rapport van Ideagen: 375 restatements in 2020; 5,1% van de bedrijven met een restatement in 2025 (populatie niet gedefinieerd).
Beweringen die wij hebben gecontroleerd en niet hebben gebruikt
Waar bij een punt staat dat wij iets niet hebben gevonden, beschrijft dat onze bronnenreview en is het geen bewijs dat zo’n bron niet bestaat.
- Topkwartielcijfers van APQC voor de afsluiting (“topprestaties sluiten in vier dagen af”). Door leveranciers herhaald onder verwijzing naar APQC, maar de kwartielwaarden worden op de open benchmarkpagina niet getoond en konden niet onafhankelijk worden geverifieerd. Hier wordt alleen de mediaan gerapporteerd.
- “Finance besteedt 75% van de tijd aan het verzamelen van data en 25% aan analyse” als actueel gepresenteerd. Het onderliggende veldwerk is van 2018–19, betreft FP&A-teams en meldt 75% voor het verzamelen van data en het beheren van processen; de 25% wordt niet als analysetijd gerapporteerd. Wij citeren het met de datum en de formulering.
- “Ongeveer 90% van de spreadsheets bevat fouten” zonder kanttekening. Dicht bij de latere veldauditcijfers (91% van 54; 88% van 113); de volledige historische steekproef van 367 laat 24% zien. De cijfers staan hierboven met hun basis.
- Eén benchmark voor de forecastafwijking over bedrijven heen. Wij vonden geen geloofwaardige. Het peer-reviewed overzicht van onderzoeken naar prognoses van het management over de winst rapporteert geen geconsolideerd percentage.
- Een aandeel van 70% “negatieve invloed op het resultaat” voor restatements in 2025. Het staat in een vakpublicatie over het rapport van Ideagen, maar de formulering maakt niet duidelijk waarvan die 70% een aandeel is, dus het wordt niet gebruikt.
- Een officieel totaalpercentage voor te late indiening. Wij zochten naar een actuele, vrij gepubliceerde officiële statistiek en vonden er geen.
- 2021 als het jaar met de meeste restatements in 20 jaar. De samenvatting van Accounting Today over het rapport van Ideagen zegt dat, maar de eigen terugblik van Audit Analytics op 2021, zoals verslagen door CFO Dive, omschreef het totaal van dat jaar als een hoogtepunt in 15 jaar, wat erop wijst dat minstens één eerder jaar hoger lag. Zonder het volledige rapport omschrijven wij 2021 alleen als een piek.